01
用文字编排每一次命中
写清谁打谁、顺序与位移方式,战斗与奇幻节拍一对一落地,而不是糊成一团。
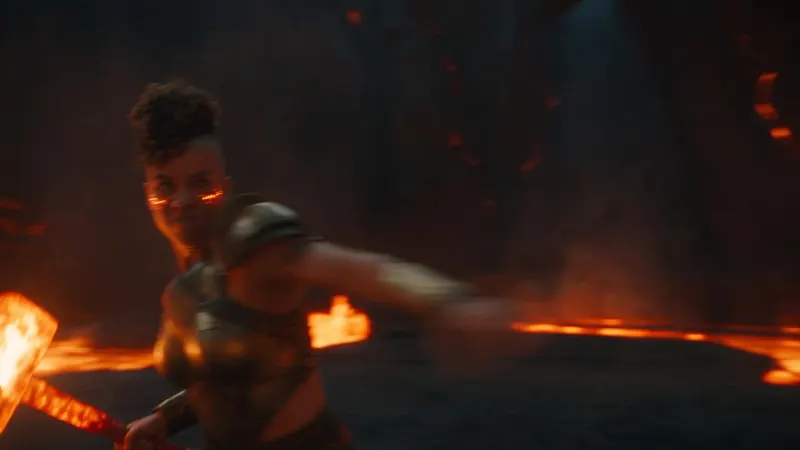
用一个简单的想法,通过 AI 生成电影感视频。
写清谁打谁、顺序与位移方式,战斗与奇幻节拍一对一落地,而不是糊成一团。
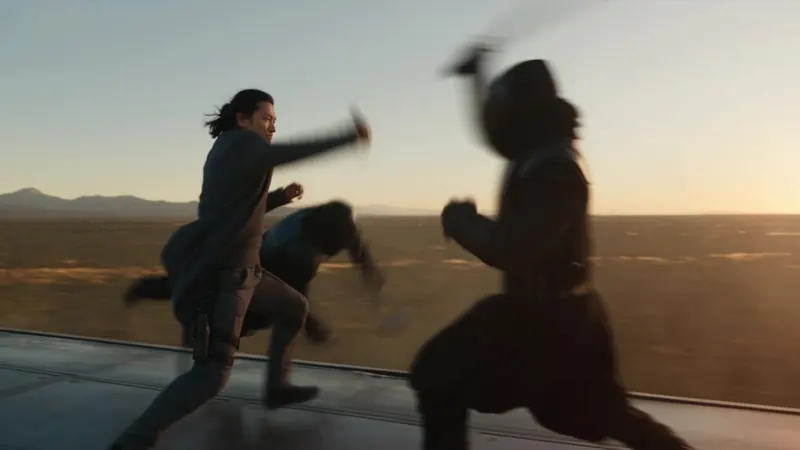
要求一条连续跟踪镜头并稳住镜头语言——跟随、弧线与揭示,少甩镜糊影。
雨夜、霓虹、湿沥青与追逐动能保持可读,主角与每个对手在全程都不串脸。
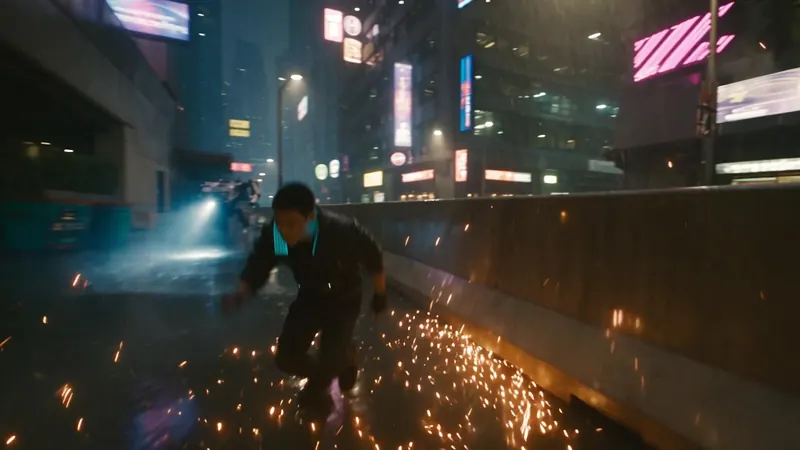
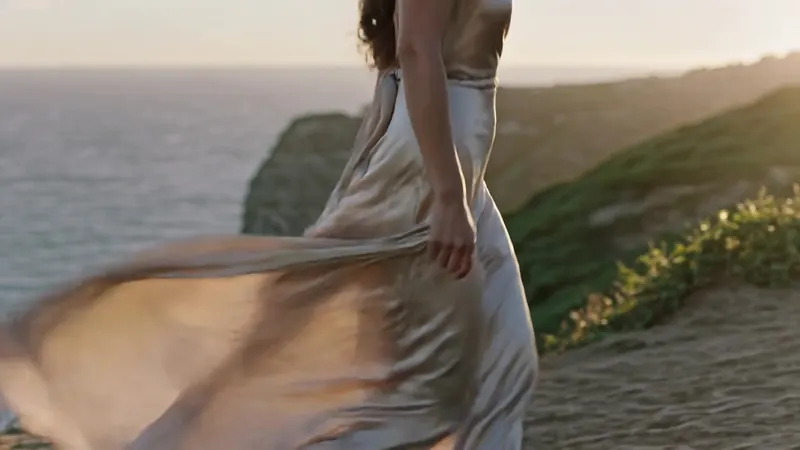
丝绸、外套与剪影保持身份,风、走位与镜头一起卖服装——适合 lookbook 与美妆大片。
Text to Video 把文字提示词变成短 AI 视频,无需起始帧。描述场景、运动与风格后,在 aiMakeVideo 的 Create 工作区生成。
你可获得多模型视频选择、与 AI Image Maker 相同的工作室、通过复刻复用 showcase 提示词,并在之后轻松切换到 Image to Video 以锁定静图外观。
使用选择器中支持文本驱动的 Kling、Seedance、Veo 或其他视频模型。草稿可用更快模型,成片再换更高画质选项。
写具体:画面中是谁/什么、如何运动、镜头路径(推进、平移、环绕)、时间与语气。避免只有空泛形容词——要搭配可见细节。
比例决定故事落在横屏、竖屏还是方形。时长控制运动展开长度,并影响积分消耗。请使用所选模型支持的时长。
在符合条件的套餐与充足积分下可以——按套餐权利用于广告、社媒与产品故事。付费投放前请在 Pricing 确认层级限制。
当你已经喜欢某张静图(来自 Text to Image、拍摄或 showcase),并需要保留该外观的运动时切换。场景还只存在于文字时,继续用 Text to Video。