01
用文字編排每一次命中
寫清誰打誰、順序與位移方式,戰鬥與奇幻節拍一對一落地,而不是糊成一團。
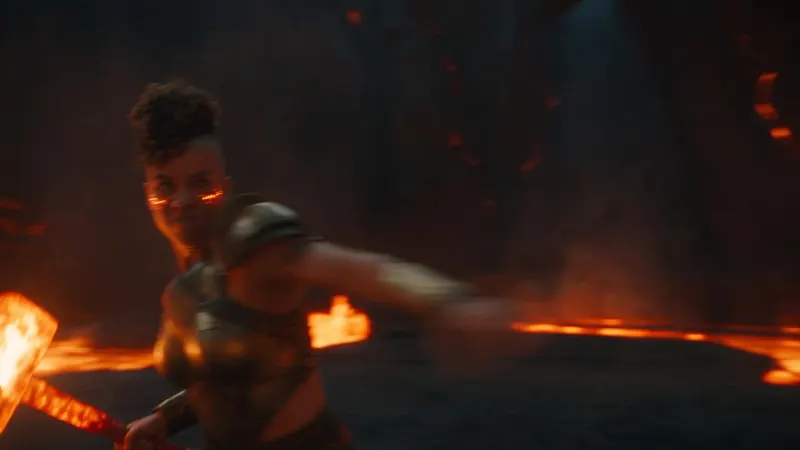
用一個簡單的想法,透過 AI 生成電影感影片。
寫清誰打誰、順序與位移方式,戰鬥與奇幻節拍一對一落地,而不是糊成一團。
要求一條連續跟蹤鏡頭並穩住鏡頭語言——跟隨、弧線與揭示,少甩鏡糊影。
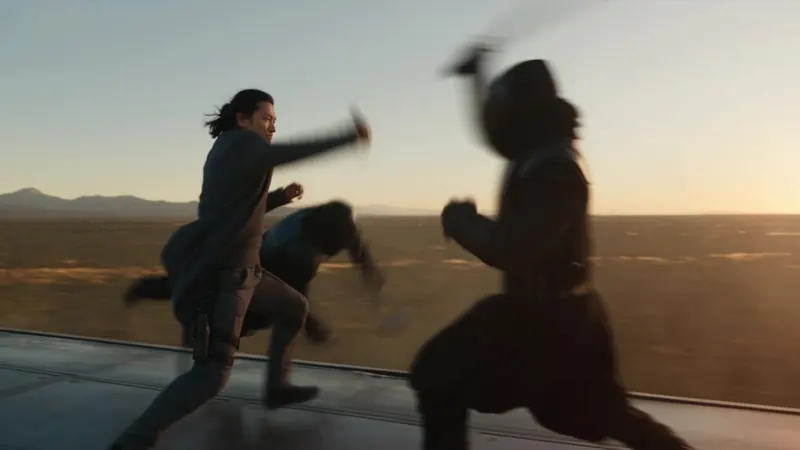
雨夜、霓虹、溼瀝青與追逐動能保持可讀,主角與每個對手在全程都不串臉。
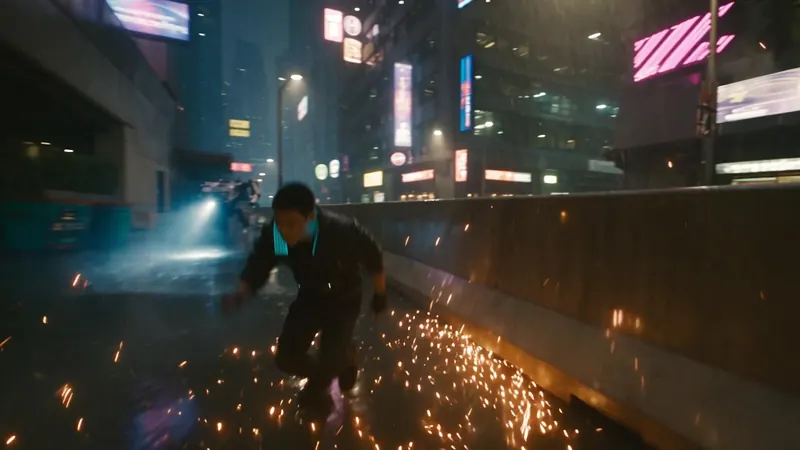
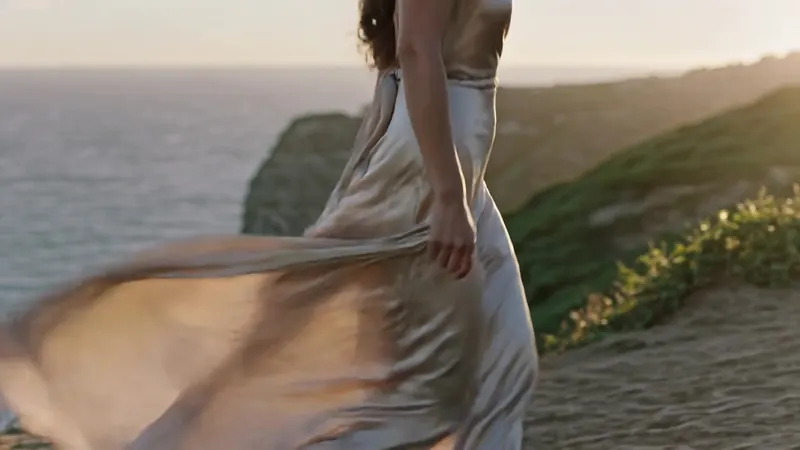
絲綢、外套與剪影保持身份,風、走位與鏡頭一起賣服裝——適合 lookbook 與美妝大片。
Text to Video 把文字提示詞變成短 AI 影片,無需起始幀。描述場景、運動與風格後,在 aiMakeVideo 的 Create 工作區生成。
你可獲得多模型影片選擇、與 AI Image Maker 相同的工作室、透過復刻複用 showcase 提示詞,並在之後輕鬆切換到 Image to Video 以鎖定靜圖外觀。
使用選擇器中支援文字驅動的 Kling、Seedance、Veo 或其他影片模型。草稿可用更快模型,成片再換更高畫質選項。
寫具體:畫面中是誰/什麼、如何運動、鏡頭路徑(推進、平移、環繞)、時間與語氣。避免只有空泛形容詞——要搭配可見細節。
比例決定故事落在橫屏、豎屏還是方形。時長控制運動展開長度,並影響積分消耗。請使用所選模型支援的時長。
在符合條件的套餐與充足積分下可以——按套餐權利用於廣告、社媒與產品故事。付費投放前請在 Pricing 確認層級限制。
當你已經喜歡某張靜圖(來自 Text to Image、拍攝或 showcase),並需要保留該外觀的運動時切換。場景還只存在於文字時,繼續用 Text to Video。