スタジオを開く

AI動画・画像プロンプトガイド

より良いプロンプトを書き、適切なモードとモデルを選び、実際のショーケース例から再作成しましょう。

1. 汎用プロンプトの公式

aiMakeVideoは自然言語に従います。これらの構成要素を積み重ねてください — 毎回すべての行が必要なわけではありませんが、明確な指示ほど制御しやすいクリップや静止画が生成されやすくなります。

被写体

画面に映る人物や物 — 人、製品、動物、またはシーンの主役。反復する場合は同一性を保ちましょう。

アクション / 動き

時間の経過とともに起こること:歩く、注ぐ、振り返る、周回する、布に風が当たる。静止画の場合は、タイムラインではなくポーズと微細な動きを示唆します。

カメラ

ショットサイズ、レンズ感、動き — プッシュイン、周回、ハンドヘルドフォロー、固定三脚。1つの明確な動きが、3つの相反する動きに勝ります。

ライティング

キーライトの方向と質 — ソフトビューティー、硬い真昼、ゴールデンアワー、ネオンリム、スタジオソフトボックス。

ムードとスタイル

全体的なルック:フォトリアルコマーシャル、エディトリアルビューティー、シネマティックスリラー、静かなライフスタイル。重要な場合は避けたいもの(テキストなし、余分な人物なし)を明記しましょう。

テンプレート

[被写体] + [アクション] + [カメラ] + [ライティング] + [環境] + [ムード]。オプション:動画の場合はタイミングビート(0〜2秒 / 2〜5秒)。
2. 適切なモードを選ぶ

すでに持っているアセットから始めましょう。後からモードを切り替えても問題ありません — 再作成と作成は同じスタジオで指示を保持します。

サンプルのプロンプトは英語のまま掲載しています。多くのモデルは英語のプロンプトを最も安定して理解するため、そのままコピーして使えます。解説はすべて日本語です。「再作成」を押すと、設定ごと読み込めます。

テキストから動画

シーンが言葉としてしか存在しない場合に最適です。被写体、動き、カメラ、ライト、ムードを1つの指示に書きましょう。長いクリップにはタイミングビートを追加します。

テキストから動画のプロンプトの書き方

  • 被写体はひとつ、動作もひとつ。 画面に映るのは誰(何)か、そしてその被写体が何をするのかを1つに絞って書きます。クリップは数秒しかないため、詰め込みすぎるとどの要素もはっきり伝わりません。
  • カメラワークは1種類だけ。 ゆっくりとしたプッシュイン、横移動のトラッキング、オービット、固定ショットのどれかを選び、速さも添えます。矛盾する複数の指示は、映像がガタつく最大の原因です。
  • 光と舞台、そして「入れないもの」を書く。 時間帯、光の向き、質感を書くと、モデルが目指すルックが定まります。すっきりした画面が必要なら、最後に “no text, no subtitles” のような除外指示を加えましょう。
弱いプロンプト

a woman walking on a cliff, beautiful, cinematic

改善したプロンプト

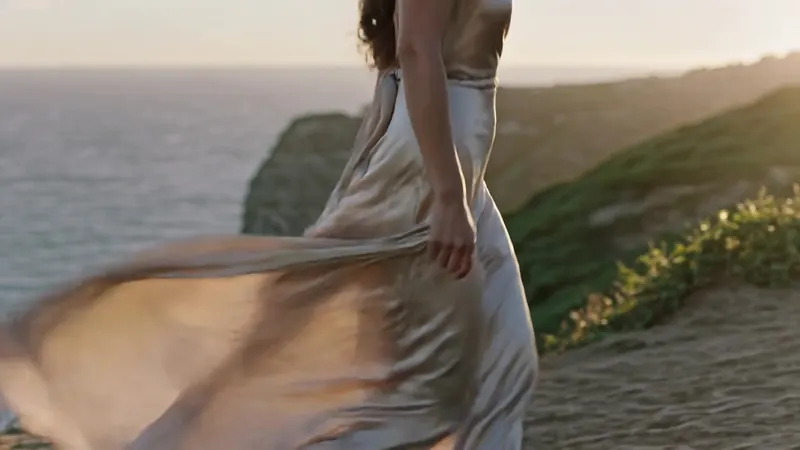
A woman in a flowing champagne silk dress walks along a cliffside path at golden hour, fabric catching the wind, warm rim light on her hair, slow lateral tracking shot, 85mm look, shallow depth of field, photoreal, no text

改善のポイント: 改善版では衣装、時間帯、1つのカメラワーク、レンズの雰囲気まで具体的に指定しています。「beautiful」や「cinematic」だけでは、モデルは何を描けばいいのか分かりません。

そのまま再作成できる実例

画像から動画

すでに気に入った静止画がある場合に最適です。まずフレームをアップロードまたは生成し、顔、服装、背景を参照に固定しながらどのように動くべきかを記述します。

画像から動画のプロンプトの書き方

  • 変えてはいけない部分を固定する。 まず、顔・衣装・商品・背景を参照画像のまま保つよう指示します。見た目はすでに画像が決めているので、言葉は説明し直すためではなく、それを守るために使います。
  • 言葉は「動き」に使う。 何がどう動くのかを書きます。呼吸、風になびく髪、ゆっくり振り向く頭、注がれる液体など。小さく物理的に自然な動きのほうが、大きなポーズ変更よりも本人らしさを保てます。
  • 長めのクリップは時間で区切る。 数秒を超える場合は、0–2s、2–5s のように動作を時間ごとに分け、各区間に1つの動作だけを割り当てます。そうすれば、すべての動きが最初の1秒に詰め込まれることはありません。
弱いプロンプト

make the bottle look cool

改善したプロンプト

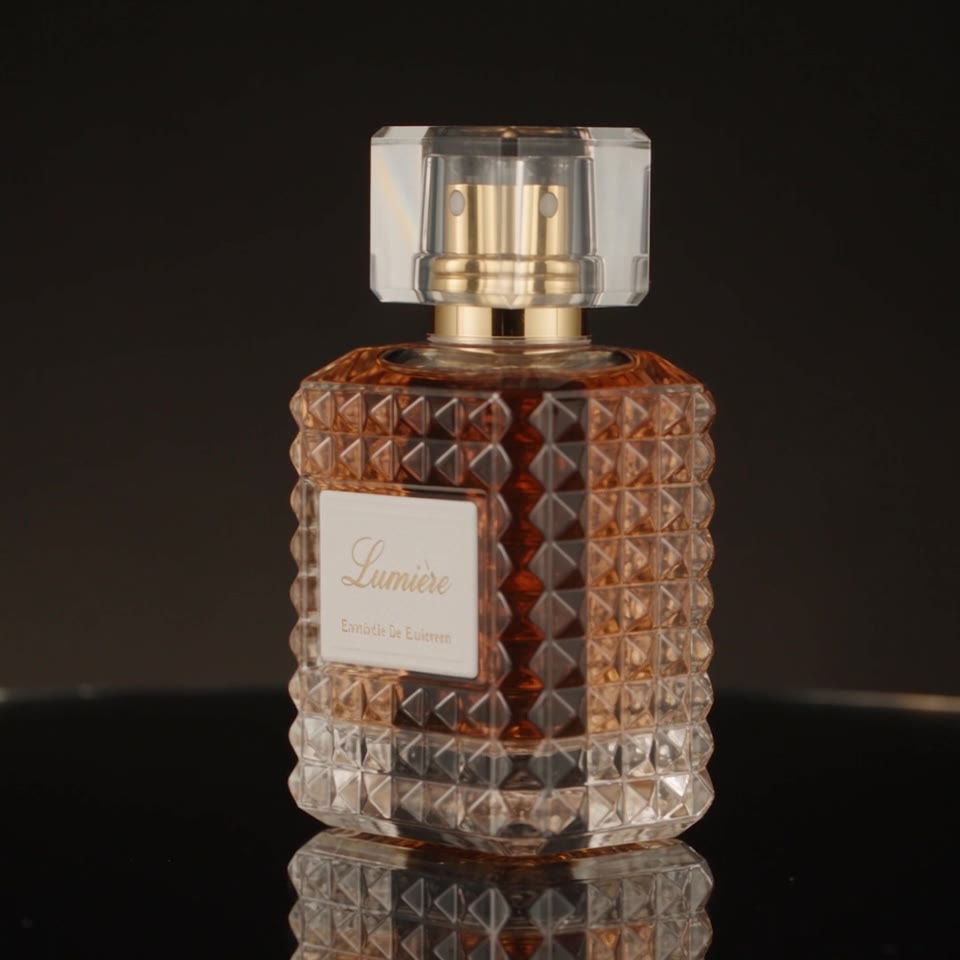
Keep the exact bottle shape, label and colors from the reference. 0–2s: slow push-in toward the bottle as light glides across the glass. 2–5s: gentle low orbit to the right while the petals in the foreground drift softly. Shallow depth of field, luxury commercial, no new text or logos

改善のポイント: 最初のプロンプトではモデルが推測するしかなく、商品デザインを変えたり、意図しない動きを加えたりしがちです。改善版はラベルを守り、区間ごとに役割を1つにし、ブランド表記を崩しかねない新しい文字も禁止しています。

そのまま再作成できる実例

テキストから画像

ゼロから新しい静止画を作るのに最適 — 製品ヒーロー、ビューティーポートレート、ライフスタイルフレーム。被写体、レンズ、ライティング、スタイルを指定します。

テキストから画像のプロンプトの書き方

  • 最初に画像の種類を伝える。 商品写真、エディトリアルなポートレート、静物、ポスターなど、カテゴリーから書き始めると、モデルは細部に入る前に構図と仕上がりを決められます。
  • 光とレンズはフォトグラファーのように。 「左からの柔らかな窓明かり、50mm、浅い被写界深度」のほうが、形容詞をいくつ並べるよりも効果的です。静止画が上質に見えるか平板に見えるかは、光で決まります。
  • 使う場所に合わせてサイズを選ぶ。 生成前にスタジオでアスペクト比を設定しましょう。フィードなら正方形、ストーリーなら縦長、バナーなら横長。後からトリミングすると細部が失われ、被写体が切れることもよくあります。
弱いプロンプト

coffee cup photo, high quality, 8k, masterpiece

改善したプロンプト

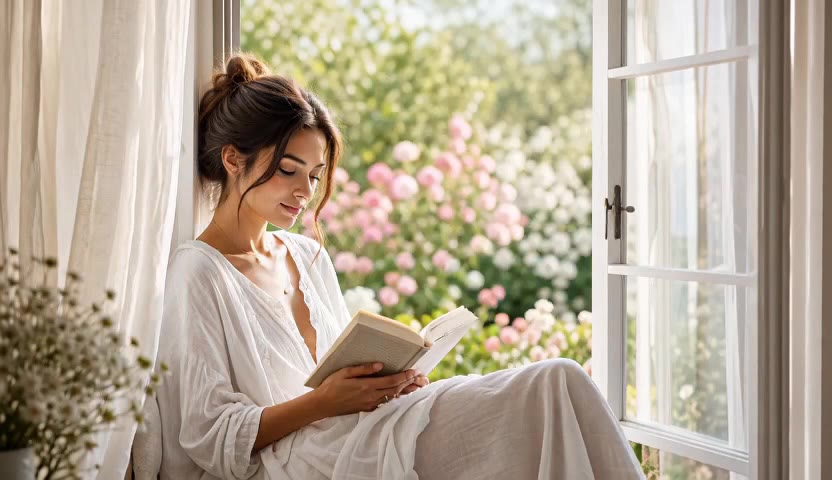
Product photo of a matte white ceramic coffee cup on a light oak table, morning window light from the left, soft shadow, thin steam rising, 50mm lens, shallow depth of field, clean minimal background, lifestyle advertising style

改善のポイント: 「8k」や「masterpiece」といったタグは情報を何も足しません。改善版は素材、置き場所、光の向き、レンズを指定しており、写真の見え方を実際に決めるのはこうした要素です。

そのまま再作成できる実例

画像から画像

スタイル変更や調整に最適。保持する要素(人物、ロゴ、製品の形状)と変更する要素(衣装、照明、背景)を指定します。

画像から画像のプロンプトの書き方

  • 残すもの、変えるものの順に書く。 まず顔立ち、ポーズ、商品の形、ロゴなど必ず残したいものを書き、そのあとで変更点を挙げます。新しい画像を説明するだけよりも、この順番のほうがモデルは確実に従います。
  • 1回の変更は1〜2か所まで。 ライティング、衣装、背景を一度に全部変えるのではなく、1〜2項目に絞ります。大きく変えたいときは、何回かに分けて重ねていきましょう。
  • きれいな参照画像から始める。 シャープで光が均一、被写体がはっきり写った元画像ほど、モデルが保てる情報は多くなります。ぼやけた写真や強いフィルターのかかった写真は、元の姿から離れやすくなります。
弱いプロンプト

make it look professional

改善したプロンプト

Keep the person's face, hairstyle and pose exactly as in the reference. Replace the background with a soft grey studio backdrop, relight with a large softbox from the front left, natural skin texture, business headshot style, no plastic retouching

改善のポイント: 「professional」は何とでも受け取れます。改善版はまず人物の同一性を守り、背景と光の2点だけを変えるよう明示しているので、仕上がりも同じ人物のままに見えます。

そのまま再作成できる実例

3. モデルの選択

aiMakeVideoはマルチモデル対応。速度、モーション品質、静止画のディテールなど、用途に合わせて選び、同じプロンプトで繰り返し調整しましょう。

動画モデル

Kling、Seedance、Veoは、モーションの忠実度、速度、ルックにおいてそれぞれ異なる強みを持っています。まずは安価/高速なティアを試し、構図が固まったら解像度やモデルをアップグレードしましょう。

画像モデル

Nano BananaやGPT Image(および関連オプション)は、ビューティー、製品、エディトリアルなスチルに適しています。高品質なティアや参照画像が多いほど、クレジットを多く消費します。

4. プロンプトでよくある失敗

期待外れの結果の多くは、いくつかの決まった癖に原因があります。次の生成にクレジットを使う前に、このリストでプロンプトを見直しましょう。

  1. 具体性ではなく形容詞を重ねる。 「息をのむ、壮大、超リアル、傑作」では、モデルにはほとんど何も伝わりません。形容詞を、素材、光源、レンズ、場所など、実際に描けるものに置き換えましょう。
  2. 1本のクリップに詰め込みすぎる。 登場人物3人、衣装チェンジ、さらにどんでん返し。数秒の動画には収まりません。1クリップにつき被写体1つ、主な動作1つに絞り、あとでつなぎましょう。
  3. カメラの指示が矛盾している。 「回り込みながらズームイン、手持ち、ドローン撮影」と書くと、モデルはどれかを選ばざるを得ず、たいてい外れます。はっきり書いた1つの動きのほうが、映像はなめらかです。
  4. 参照画像を言葉で説明し直す。 画像から動画・画像から画像では、見た目はすでに画像が担っています。言葉で繰り返すと、かえってモデルが解釈し直してしまうことがあります。残すものを書いたら、あとは変える部分に言葉を使いましょう。
  5. 画面内の文字に頼る。 文字、ロゴ、キャプションは、多くのモデルで正確に描画されません。文字はあとから編集ソフトで入れ、すっきりした画面が必要なときは “no text, no subtitles” と書きましょう。
  6. 1回失敗しただけで全部書き直す。 カメラワーク、光、モデルなど、変えるのは一度に1つだけにすると、何が効いたのかが分かります。まず短い尺と最低解像度で試し、構図が決まってからスケールアップしましょう。

5. クレジット、比率、長さ

すべてのジョブは実行前にクレジットを見積もります。長さが長いほど、解像度が高いほど、プレミアムモデルほど、参照画像が多いほどコストが上がります。

アスペクト比

チャンネルに必要なフレーミングを選びましょう — YouTube向けなら16:9、縦向きなら9:16、フィードなら1:1。最終的なクロップに比率を合わせて、フレーム外のモーションを無駄にしないようにしましょう。

長さ

短いクリップはクレジット消費が少なく、プロンプトも上手く書けます。短いテイクで構図を固め、ルックが決まったら長さを延ばしましょう。

無料で開始

無料トライアルと登録クレジットは地域によって異なります。プランとパックはほとんどの国でご利用いただけます — 料金をご覧ください。閲覧にカードは不要です。

料金を見る

6. 制作を開始

共有スタジオフィードの作成画面を開くか、ツールページに直接移動しましょう。強力な出発点となるブリーフが欲しいときは、いつでもショーケースから再現できます。

ガイドFAQ

モデルごとにプロンプトのスタイルを変える必要がありますか?

まずは同じ明確なフォーミュラを使いましょう。必要な場合のみモデルごとに調整してください — 短いビートを好むものもあれば、豊富なカメラノートを許容するものもあります。毎回ゼロから書き直すのではなく、出力を比較しましょう。

テキストから始めるべきですか、画像から始めるべきですか?

すでに気に入ったフレームがある場合は、Image to Video または Image to Image を使用してください。アイデアが言葉としてのみ存在する場合は、Text to Video または Text to Image から始めて、その後オプションで静止画をアニメーション化します。

ショーケースのプロンプトを再利用するにはどうすればよいですか?

ホームページのショーケースで「Recreate」をタップします。ブリーフが Create(または現在のツールコンポーザー)に読み込まれます。編集し、モデルを切り替え、比率を設定してから生成します。

プロンプトは英語で書くべきですか?

必須ではありませんが、通常は英語がいちばん確実です。多くの動画・画像モデルは、英語のプロンプトに最も正確に従う傾向があります。このガイドのサンプルプロンプトが英語のままなのもそのためです。日本語で下書きする場合も、被写体・動作・カメラ・光・雰囲気という同じ構成を保ち、カメラワークやライティングなどの重要な用語は英語で書くことを検討してください。

動画のプロンプトはどのくらいの長さがよいですか?

5秒前後のクリップなら、英語で40〜80語ほどあれば十分です。被写体、動作、1つのカメラワーク、光、雰囲気を入れましょう。長いクリップではもう少し書いても構いませんが、増えた分は形容詞ではなく時間の区切り(0–2s、2–5s)に使います。何段落にもなると細部が抜け落ち始めるので、画面を変えない言葉は削りましょう。

動画がプロンプト通りにならないのはなぜですか?

多くの場合、一度に求めすぎているか、肝心な部分があいまいです。被写体1つ、動作1つ、カメラワーク1つまで絞ってから、少しずつ細部を足していきましょう。人物や商品を正確に再現したいなら、先に静止画を生成またはアップロードし、画像から動画で動かしてください。見た目を固定するには、言葉よりも参照画像のほうがはるかに確実です。